Wenn der CDN KI-Crawler blockiert und deine robots.txt nichts ändert
Der Browser lädt die Seite, der KI-Crawler bekommt 403: Wahrscheinlich blockiert der CDN den KI-Crawler vor deinem Server. So findest du die Edge und die richtige Einstellung.
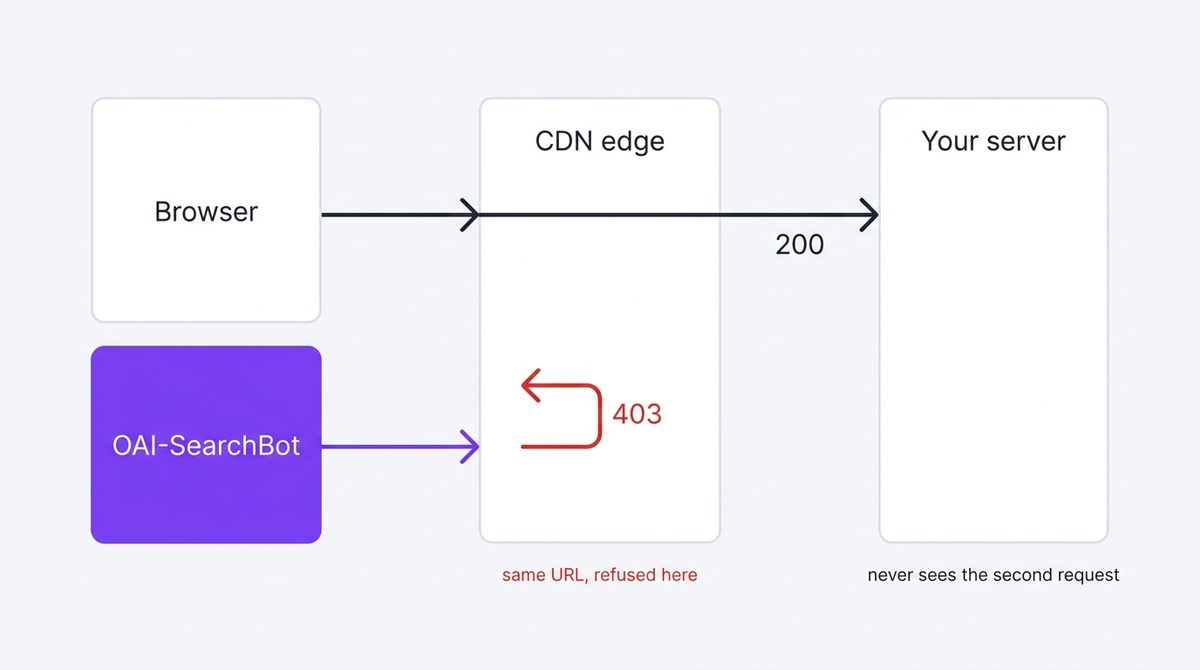
Wenn dein Browser eine Seite lädt, ein KI-Crawler aber 403 bekommt, blockiert mit hoher Wahrscheinlichkeit der CDN den KI-Crawler und nicht dein Server. Die Edge antwortet, bevor dein Server die Anfrage sieht, und ein Antwort-Header verrät den Anbieter. Finde zuerst die Edge und gehe dann zu den Bot-Einstellungen dieses Anbieters. Eigene Dateien zu ändern hebt keinen Block auf, den dein Hosting gesetzt hat.
Lies das zuerst
Dieses Kapitel beginnt dort, wo prüfen, ob KI deine Website lesen kann endet. Wenn diese Prüfung für alle Crawler 200 zurückgibt, gibt es hier nichts zu reparieren. Komm zurück, wenn etwas 403 oder 503 liefert: Das ist das Symptom, das dieses Kapitel diagnostiziert.
Warum ein CDN blockiert, was deine robots.txt erlaubt
Dein CDN antwortet, bevor dein Server die Anfrage erhält. Es führt eigene Bot-Regeln aus, die der Anbieter ausliefert und nach seinem Zeitplan aktualisiert, und es fragt robots.txt nicht für diese Entscheidung. Deshalb können beide dauerhaft widersprechen: Deine Datei sagt „kommt rein“, die Edge sagt „nein“, und beide arbeiten wie vorgesehen.
Niemand fragt dich um Erlaubnis, einen Standard in deinem Namen zu ändern. Prüfe nach jedem Tarifwechsel.
Den CDN finden, der KI-Crawler blockiert – mit einem Befehl
Du musst es nicht wissen. Die Antwort-Header sagen es, weil jede große Edge ihre eigene Anfrage-ID setzt. Ein curl, dann vergleichst du die Header-Namen mit der Tabelle.
curl -sI -A "Mozilla/5.0 (compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot)" \
https://example.com/ | grep -iE 'server|cf-ray|x-vercel|x-nf-request|x-served-by|x-amz-cf-id|x-cache'| Header | Edge | Auch zu sehen |
|---|---|---|
cf-ray | Cloudflare | server: cloudflare, cf-cache-status |
x-vercel-id | Vercel | server: Vercel, x-vercel-cache |
x-nf-request-id | Netlify | server: Netlify |
x-amz-cf-id | AWS CloudFront | x-cache |
x-served-by + x-cache | Fastly | ein eigener server |
| keiner | Kein CDN oder eines, das sich versteckt | nur server lesen |
Was der Test auf elf Websites zeigte
Am 15. August 2026 schickte ich diese exakte Anfrage mit dem Agenten OAI-SearchBot an elf bekannte Websites. Alle antworteten mit 200. Keine bekannte Markenseite verweigerte an diesem Tag einen KI-Suchcrawler an der Edge. Das ist nützlich zu wissen, bevor du annimmst, der Block liege bei dir.
Das hilfreichere Ergebnis war, wer hinter Cloudflare steckt. shopify.com und webflow.com antworteten beide mit cf-ray. Wenn du einen Shop oder eine Website auf einer dieser Plattformen betreibst, gelten für dich die Bot-Regeln von Cloudflare, auch wenn du dieses Konto nicht selbst verwaltest.
Eine Einschränkung, dieselbe wie bei jeder Prüfung in diesem Handbuch: Die Anfragen kamen von meiner Adresse, nicht von der des Crawlers. Regeln, die nach IP-Bereich filtern, bleiben für diesen Test unsichtbar.
Wo jede Plattform ihre KI-Crawler-Steuerung versteckt
Suche die Funktion nach Namen, nicht nach einem Menüpfad. Anbieter verschieben Menüs ständig, und ein veralteter Pfad schickt dich auf die Suche nach etwas, das längst umbenannt wurde.
| Plattform | Wonach suchen | Standard |
|---|---|---|
| Cloudflare | AI Crawl Control | In allen Tarifen verfügbar |
| Vercel | Regelsatz für KI-Crawler | Inaktiv, angezeigt als Allow |
| Vercel | Verwaltete Bot-Schutzregeln | Inaktiv, angezeigt als Off |
| Shopify | Theme-Vorlage robots.txt.liquid | Shopifys Standardregeln |
| Netlify / CloudFront | WAF- oder Firewallregeln pro Agent | Keine KI-spezifischen Regeln |
Vercel dokumentiert beide Regelsätze als ausgeschaltet, bis du sie einschaltest. Eine Vercel-Website, die KI-Crawler ablehnt, wird deshalb oft woanders abgelehnt. Quellen: Cloudflare, Vercel, Shopify.
Bei zwei gestapelten Edges antwortet nur die äußere
Viele Websites setzen eine Plattform vor eine andere; Cloudflare vor Vercel ist die häufige Kombination. Der äußere Dienst antwortet, also siehst du seine Header und seine Regeln greifen. Die Bot-Einstellungen der inneren Plattform werden womöglich nie gefragt.
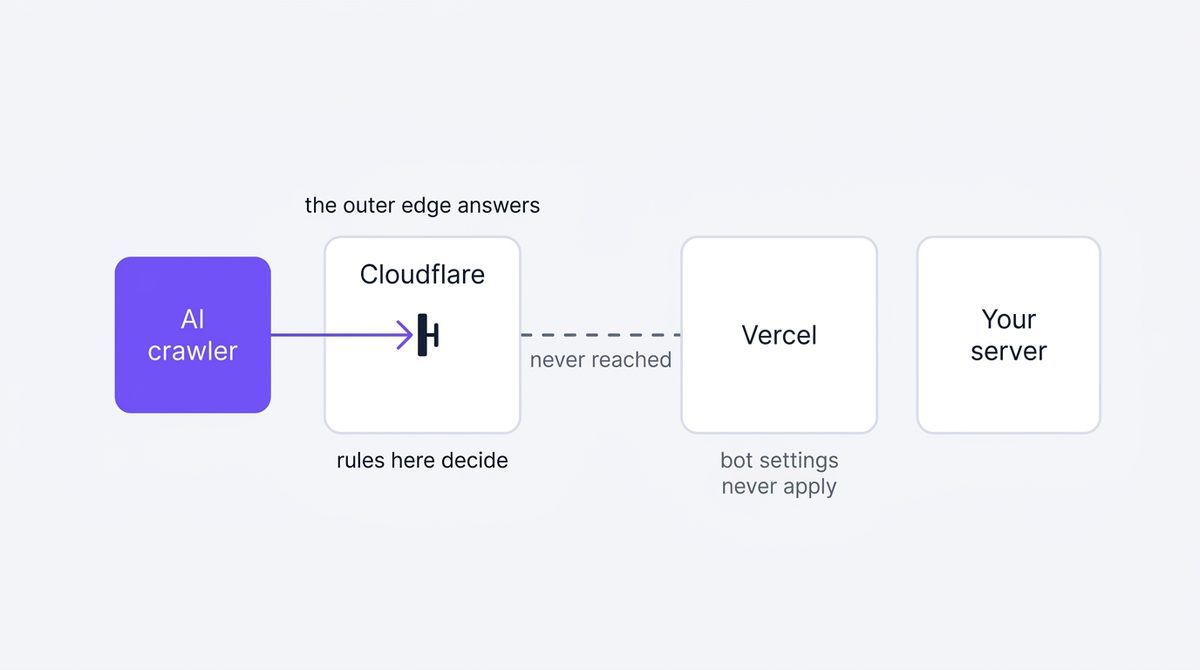
Vercel sagt es in seiner Dokumentation deutlich: „Bot Protection doesn't work when a reverse proxy (e.g. Cloudflare, Azure, or other CDNs) is placed in front of your Vercel deployment.“ Wenn deine Header cf-ray zeigen, beginne bei Cloudflare, auch wenn du dich als Vercel-Website siehst.
Drei Arten, sich zu vertun
Jede kostet einen Nachmittag an einer Stelle, an der die Antwort nie lag.
- robots.txt ändern, um einen 403 zu beheben. Ein 403 bedeutet, dass die Anfrage abgelehnt wurde. robots.txt liest der Anfragende erst nach der Antwort; die Datei kann die Ablehnung nicht rückgängig machen. Repariere die Edge und nutze robots.txt danach, um deinen Wunsch zu formulieren.
- Mit dem Browser testen und sich für fein erklären. Bot-Regeln greifen am Agenten, und dein Browser ist genau der Client, der das Problem nicht reproduziert. Teste immer mit dem Agenten des Crawlers erneut.
- Die innere Plattform reparieren, während die äußere ablehnt. Prüfe die Header, bevor du eine Einstellung änderst, sonst drehst du an einem Dienst, der die Anfrage nie gesehen hat.
Häufige Fragen
Mein Hoster sagt, er blockiere keine KI-Crawler. Warum bekomme ich 403?
Verwaltete WAF-Regeln, Ratenlimits und Challenge-Seiten erzeugen Ablehnungen, ohne als KI-Block etikettiert zu sein. Ein 503 mit Zwischenseite ist eine Challenge, und Crawler lösen keine Challenges: Behandle es als Block.
Kann ich einen CDN-Block von einem Server-Block unterscheiden?
Meistens ja. Eine Edge-Ablehnung kommt schnell, trägt die Header des CDN und keinen deiner Anwendung. Stehen in der Antwort die Header deines Frameworks oder eine von deiner App gerenderte Seite, hat die Anfrage dich erreicht.
Warum gibt es keine Klick-für-Klick-Screenshots?
Weil wir Menüpfade veröffentlichen würden, die wir bei jedem Anbieter-Update nicht erneut prüfen können, und ein falscher Pfad ist schlimmer als keiner. Funktionsnamen ändern sich viel langsamer als Menüs.
Nächster Schritt
Wenn jeder Crawler 200 bekommt, ist nicht mehr die Erreichbarkeit das Problem, sondern ob es sich lohnt, dich zu crawlen. Dann wählst du die Suchen aus, bei denen du kurz vor dem Gewinn stehst; dort wechselt das Handbuch von der Verkabelung zum Inhalt.
Die Diagnose ist der schnelle Teil. Die Änderung machen, veröffentlichen und das Update zur Indexierung anstoßen ist der Punkt, an dem die meisten Websites hängen bleiben.
Teil von dem QueryWin-Handbuch · Stufe 1