Quand le CDN bloque les robots IA et que votre robots.txt ne fait rien
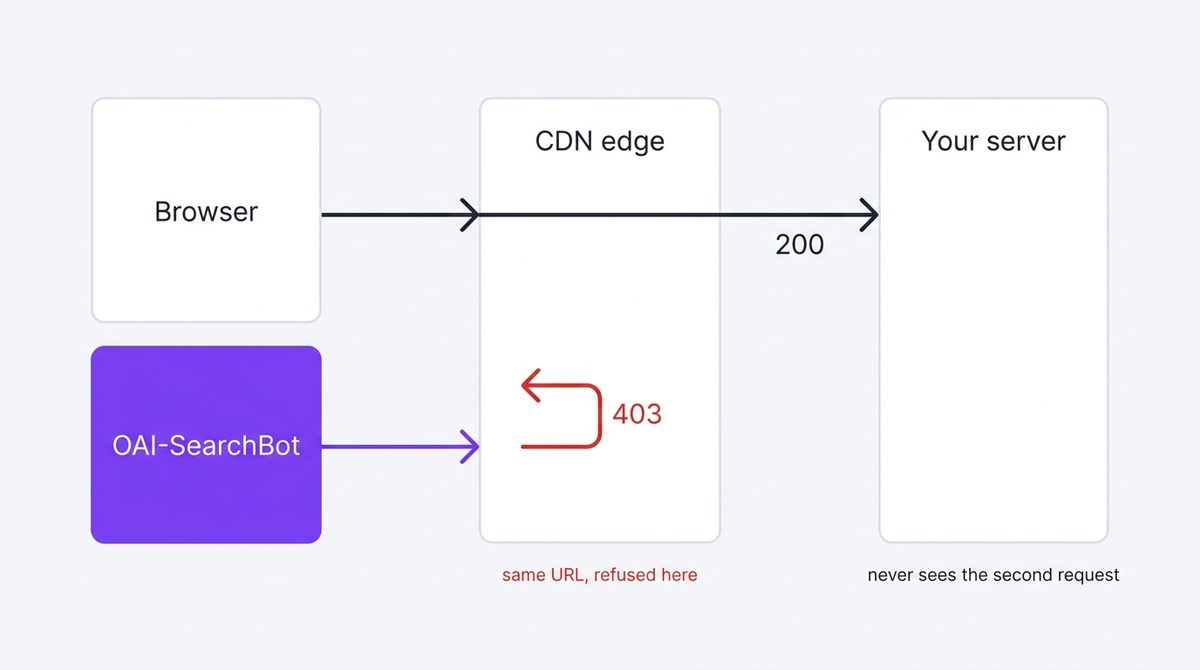
Un navigateur charge la page, un robot IA reçoit un 403 : le CDN bloque probablement le robot IA avant votre serveur. Voici comment identifier la périphérie et où chercher le réglage.
Quand votre navigateur charge une page mais qu’un robot IA reçoit un 403, le CDN bloque très probablement le robot IA, pas votre serveur. La réponse part de la périphérie avant même que votre serveur ne voie la requête, et un en-tête suffit à identifier le fournisseur. Trouvez d’abord la périphérie, puis allez dans les réglages de robots de ce fournisseur : modifier vos propres fichiers ne lèvera pas un blocage appliqué par votre hébergeur.
À lire avant
Ce chapitre commence là où s’arrête vérifier si l’IA peut lire votre site. Si ce contrôle renvoie 200 pour tous les robots, il n’y a rien à corriger ici. Revenez quand une réponse est 403 ou 503 : c’est le symptôme que ce chapitre diagnostique.
Pourquoi un CDN bloque ce que votre robots.txt autorise
Votre CDN répond avant que votre serveur ne reçoive la requête. Il applique ses propres règles de robots, livrées par le fournisseur, mises à jour selon son calendrier, et il ne consulte pas robots.txt pour décider. Les deux peuvent donc se contredire durablement : votre fichier dit d’entrer, la périphérie dit non, et les deux fonctionnent comme prévu.
Personne ne vous demande la permission de changer un réglage par défaut à votre place. Vérifiez après chaque changement d’offre.
Trouver le CDN qui bloque les robots IA en une commande
Vous n’avez pas besoin de le savoir. Les en-têtes de réponse le disent, car chaque grande périphérie signe sa propre requête. Une commande curl, puis comparez les noms d’en-têtes au tableau.
curl -sI -A "Mozilla/5.0 (compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot)" \
https://example.com/ | grep -iE 'server|cf-ray|x-vercel|x-nf-request|x-served-by|x-amz-cf-id|x-cache'| En-tête | Périphérie | Aussi vu |
|---|---|---|
cf-ray | Cloudflare | server: cloudflare, cf-cache-status |
x-vercel-id | Vercel | server: Vercel, x-vercel-cache |
x-nf-request-id | Netlify | server: Netlify |
x-amz-cf-id | AWS CloudFront | x-cache |
x-served-by + x-cache | Fastly | un server personnalisé |
| aucun | Pas de CDN, ou un CDN discret | lire server seul |
Ce qu’un test sur onze sites a montré
Le 15 août 2026, j’ai envoyé cette requête exacte, avec l’agent OAI-SearchBot, à onze sites connus. Tous ont répondu 200. Aucun site grand public n’a refusé un robot de recherche IA à la périphérie ce jour-là, ce qui vaut la peine d’être su avant de supposer que le blocage vient de vous.
Le résultat le plus utile concernait l’infrastructure derrière Cloudflare. shopify.com et webflow.com répondaient tous deux avec cf-ray. Si vous exploitez une boutique ou un site sur l’une de ces plateformes, les règles de robots qui comptent pour vous sont celles de Cloudflare, même si vous ne gérez pas directement ce compte.
Une réserve, la même que pour tous les contrôles de ce manuel : ces requêtes partaient de mon adresse, pas de celle du robot. Les règles qui filtrent par plage d’IP restent invisibles à ce test.
Où chaque plateforme cache ses contrôles de robots IA
Cherchez la fonction par son nom, pas par un chemin de menu. Les fournisseurs déplacent les menus en permanence, et un chemin périmé vous envoie chercher quelque chose qui a été renommé.
| Plateforme | À chercher | Défaut |
|---|---|---|
| Cloudflare | AI Crawl Control | Disponible sur toutes les offres |
| Vercel | Règles gérées pour robots IA | Inactives, affichées comme Allow |
| Vercel | Règles gérées de protection des robots | Inactives, affichées comme Off |
| Shopify | Modèle de thème robots.txt.liquid | Règles par défaut de Shopify |
| Netlify / CloudFront | Règles WAF ou pare-feu sur l’agent | Aucun jeu de règles spécifique à l’IA |
Vercel documente ses deux jeux de règles comme désactivés jusqu’à activation. Un site Vercel qui refuse les robots IA est donc souvent refusé ailleurs. Sources : Cloudflare, Vercel, Shopify.
Quand deux périphéries se superposent, seule l’extérieure répond
Beaucoup de sites placent une plateforme devant une autre ; Cloudflare devant Vercel est la combinaison courante. Le service extérieur répond, donc ce sont ses en-têtes que vous voyez et ses règles qui s’appliquent. Les réglages de robots de la plateforme intérieure peuvent ne jamais être consultés.
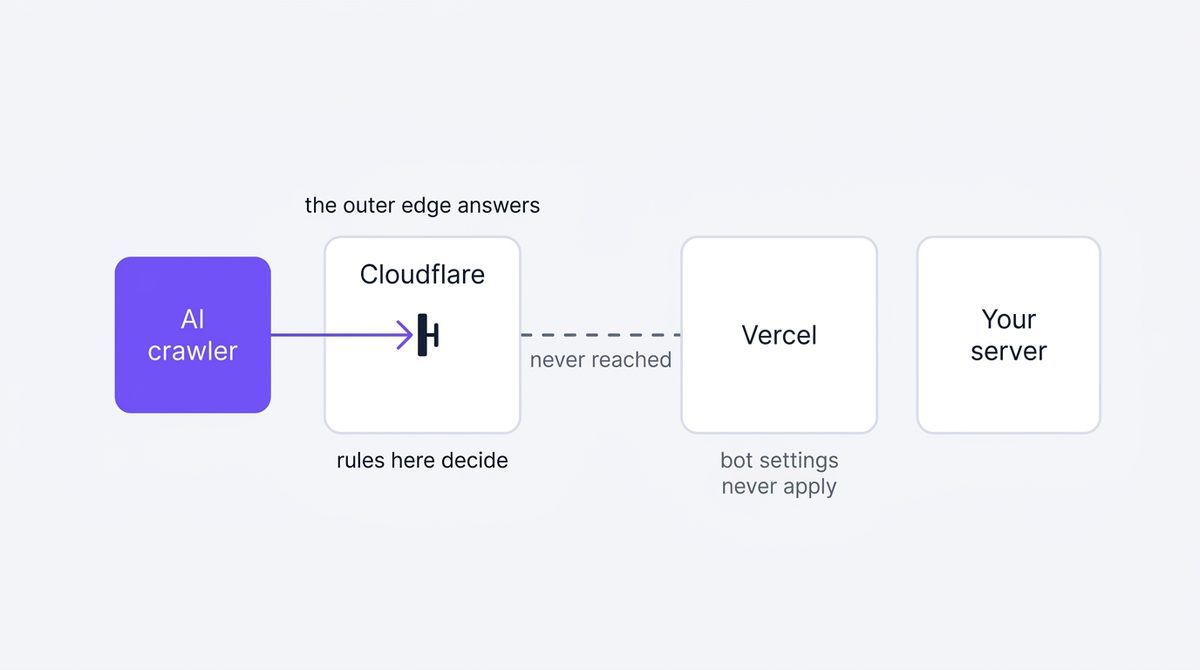
Vercel le dit clairement dans sa documentation : « Bot Protection doesn't work when a reverse proxy (e.g. Cloudflare, Azure, or other CDNs) is placed in front of your Vercel deployment. » Si vos en-têtes montrent cf-ray, commencez par Cloudflare même si vous vous considérez comme un site Vercel.
Trois façons de se tromper
Chacune coûte un après-midi là où la réponse ne pouvait pas se trouver.
- Modifier robots.txt pour corriger un 403. Un 403 signifie que la requête a été refusée. robots.txt est un fichier que le demandeur lit après avoir reçu une réponse ; il ne peut pas annuler un refus. Corrigez la périphérie, puis utilisez robots.txt pour dire ce que vous voulez vraiment.
- Tester avec un navigateur et conclure que tout va bien. Les règles de robots reposent sur l’agent, et votre navigateur est précisément le client qui ne reproduira pas le problème. Retestez toujours avec l’agent du robot.
- Corriger la plateforme intérieure alors que l’extérieure refuse. Vérifiez les en-têtes avant de changer un réglage, sinon vous tournez des boutons sur un service qui n’a jamais vu la requête.
Questions fréquentes
Mon hébergeur dit qu’il ne bloque pas les robots IA. Pourquoi un 403 ?
Les règles WAF gérées, les limites de débit et les pages de challenge produisent des refus sans être étiquetées « blocage IA ». Un 503 avec une page intermédiaire est un challenge, et les robots ne résolvent pas les challenges : traitez-le comme un blocage.
Peut-on distinguer un blocage CDN d’un blocage serveur ?
En général oui. Un refus de périphérie arrive vite, porte les en-têtes du CDN et aucun en-tête de votre application. Si la réponse contient les en-têtes de votre framework ou une page rendue par votre application, la requête vous a atteint.
Pourquoi ce chapitre ne donne-t-il pas de captures d’écran pas à pas ?
Parce que nous publierions des chemins de menu que nous ne pouvons pas revérifier à chaque mise à jour des fournisseurs, et un chemin faux est pire que rien. Les noms de fonctions changent bien moins vite que les menus.
Étape suivante
Quand chaque robot reçoit un 200, le problème n’est plus d’être accessible mais d’être digne d’être récupéré. Il faut alors choisir les recherches que vous êtes près de gagner, et c’est là que le manuel passe de la plomberie au contenu.
Le diagnostic est la partie rapide. Faire la modification, publier et pousser la mise à jour pour l’indexation est l’endroit où la plupart des sites s’arrêtent.
Fait partie du guide QueryWin · Niveau 1