Quando il CDN blocca i crawler IA e il robots.txt non basta
Il browser apre la pagina, il crawler IA riceve 403: probabilmente il CDN blocca il crawler IA prima del tuo server. Ecco come trovare l’edge e l’impostazione giusta.
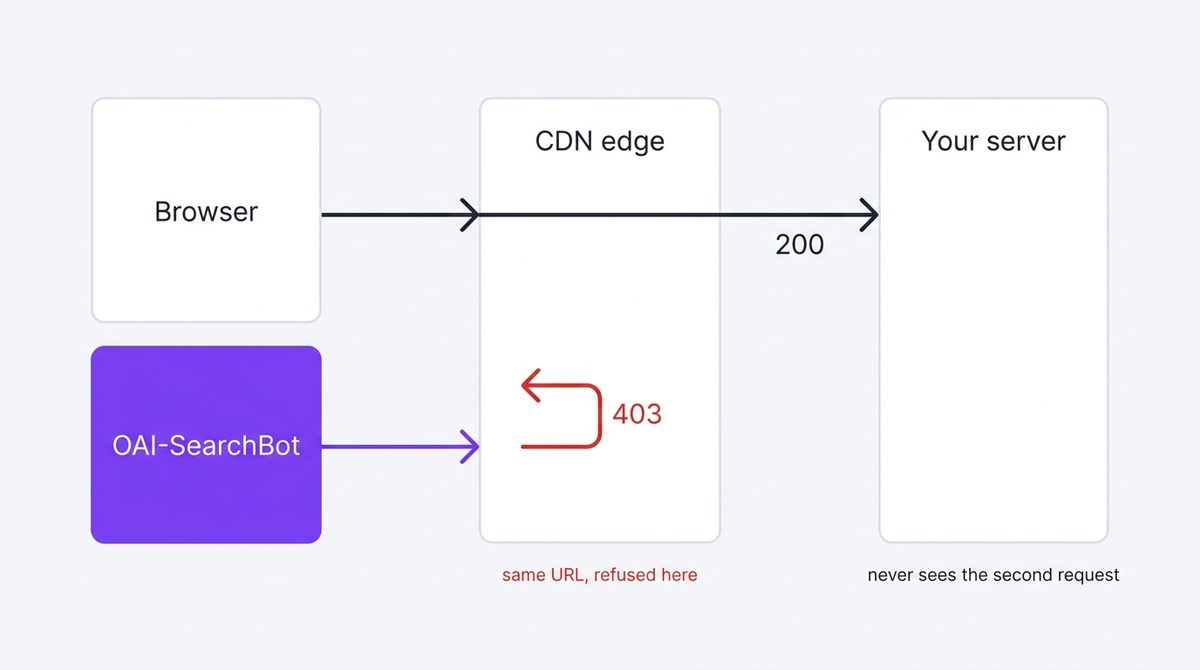
Se il browser carica la pagina ma un crawler IA riceve un 403, è quasi certo che il CDN blocca il crawler IA e non che ci sia un guasto sul tuo server. L’edge risponde prima che il server veda la richiesta, e un solo header basta a identificare il fornitore. Prima individua l’edge, poi vai ai controlli bot di quel fornitore: modificare i tuoi file non rimuove un blocco applicato dall’hosting.
Leggi prima questo
Questo capitolo parte da dove finisce verificare se l’IA può leggere il sito. Se quel controllo restituisce 200 per tutti i crawler, qui non c’è nulla da correggere. Torna quando qualcosa restituisce 403 o 503: è il sintomo che questo capitolo diagnostica.
Perché un CDN blocca ciò che il tuo robots.txt permette
Il CDN risponde prima che il server riceva la richiesta. Applica regole bot proprie, distribuite dal fornitore e aggiornate secondo il suo calendario, e non consulta robots.txt per decidere. I due possono quindi contraddirsi per sempre: il tuo file dice di entrare, l’edge dice no, ed entrambi funzionano come previsto.
Nessuno ti chiede il permesso di cambiare un valore predefinito al posto tuo. Controlla dopo ogni cambio di piano.
Trovare il CDN che blocca i crawler IA con un comando
Non devi saperlo in anticipo. Gli header di risposta lo dicono, perché ogni grande edge firma la propria richiesta. Un curl, poi confronti i nomi degli header con la tabella.
curl -sI -A "Mozilla/5.0 (compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot)" \
https://example.com/ | grep -iE 'server|cf-ray|x-vercel|x-nf-request|x-served-by|x-amz-cf-id|x-cache'| Header | Edge | Anche visto |
|---|---|---|
cf-ray | Cloudflare | server: cloudflare, cf-cache-status |
x-vercel-id | Vercel | server: Vercel, x-vercel-cache |
x-nf-request-id | Netlify | server: Netlify |
x-amz-cf-id | AWS CloudFront | x-cache |
x-served-by + x-cache | Fastly | un server personalizzato |
| nessuno | Nessun CDN, o uno che si nasconde | leggi solo server |
Cosa ha mostrato il test su undici siti
Il 15 agosto 2026 ho inviato questa richiesta esatta, con l’agente OAI-SearchBot, a undici siti noti. Tutti hanno risposto 200. Nessun sito di grande marca ha rifiutato un crawler di ricerca IA all’edge quel giorno, un dato utile prima di dare per scontato che il blocco sia tuo.
Il risultato più utile è stato chi sta dietro Cloudflare. shopify.com e webflow.com rispondevano entrambi con cf-ray. Se gestisci un negozio o un sito su una di queste piattaforme, le regole bot che ti riguardano sono quelle di Cloudflare, anche se non amministri tu quell’account.
Una precisazione, la stessa di ogni controllo in questo manuale: le richieste partivano dal mio indirizzo, non da quello del crawler. Le regole che filtrano per intervallo IP restano invisibili a questo test.
Dove ogni piattaforma tiene i controlli per i crawler IA
Cerca la funzione per nome, non per percorso di menu. I fornitori spostano i menu di continuo, e un percorso vecchio ti manda a cercare qualcosa che è stato rinominato.
| Piattaforma | Cosa cercare | Predefinito |
|---|---|---|
| Cloudflare | AI Crawl Control | Disponibile su tutti i piani |
| Vercel | Set di regole per crawler IA | Inattivo, mostrato come Allow |
| Vercel | Regole gestite di protezione bot | Inattivo, mostrato come Off |
| Shopify | Template del tema robots.txt.liquid | Regole predefinite di Shopify |
| Netlify / CloudFront | Regole WAF o firewall per agente | Nessuna regola specifica per l’IA |
Vercel documenta entrambi i set come disattivati finché non li accendi. Un sito su Vercel che rifiuta i crawler IA spesso viene rifiutato altrove. Fonti: Cloudflare, Vercel, Shopify.
Con due edge impilati risponde solo quello esterno
Molti siti mettono una piattaforma davanti a un’altra; Cloudflare davanti a Vercel è la coppia comune. Risponde il servizio esterno, quindi vedi i suoi header e agiscono le sue regole. Le impostazioni bot della piattaforma interna possono non essere mai consultate.
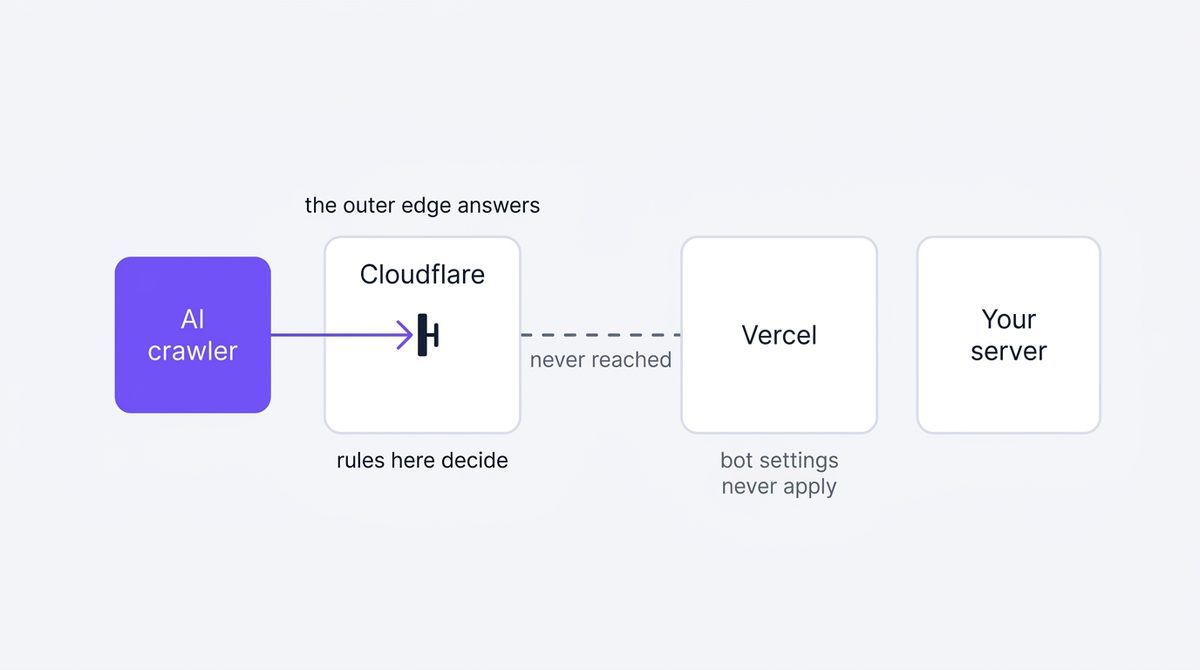
Vercel lo dice nella sua documentazione: «Bot Protection doesn't work when a reverse proxy (e.g. Cloudflare, Azure, or other CDNs) is placed in front of your Vercel deployment.» Se i tuoi header mostrano cf-ray, parti da Cloudflare anche se ti consideri un sito Vercel.
Tre modi di sbagliare
Ognuno costa un pomeriggio in un posto dove la risposta non c’era.
- Modificare robots.txt per correggere un 403. Un 403 significa che la richiesta è stata rifiutata. robots.txt è un file che il richiedente legge dopo aver ricevuto una risposta, quindi non può annullare un rifiuto. Correggi l’edge, poi usa robots.txt per dire ciò che vuoi davvero.
- Provare col browser e concludere che va tutto bene. Le regole bot si basano sull’agente, e il browser è proprio il client che non riprodurrà il problema. Riprova sempre con l’agente del crawler.
- Correggere la piattaforma interna mentre quella esterna rifiuta. Controlla gli header prima di cambiare un’impostazione, altrimenti giri manopole su un servizio che non ha mai visto la richiesta.
Domande frequenti
Il mio hosting dice che non blocca i crawler IA. Perché ricevo 403?
Regole WAF gestite, limiti di frequenza e pagine di challenge producono rifiuti senza essere etichettati come blocco IA. Un 503 con pagina intermedia è una challenge, e i crawler non risolvono le challenge: trattalo come un blocco.
Si può distinguere un blocco del CDN da uno del server?
Di solito sì. Un rifiuto dell’edge arriva veloce, porta gli header del CDN e nessuno della tua applicazione. Se nella risposta ci sono gli header del tuo framework o una pagina renderizzata dalla tua app, la richiesta ti è arrivata.
Perché il capitolo non mostra passaggi con screenshot del pannello?
Perché pubblicheremmo percorsi di menu che non possiamo riverificare a ogni aggiornamento dei fornitori, e un percorso sbagliato è peggio di nessuno. I nomi delle funzioni cambiano molto più lentamente dei menu.
Passo successivo
Quando ogni crawler riceve 200, il problema non è più essere raggiungibile ma meritare di essere scansionato. Significa scegliere le ricerche che sei vicino a vincere; lì il manuale passa dall’impianto al contenuto.
La diagnosi è la parte veloce. Fare la modifica, pubblicarla e spingere l’aggiornamento per l’indicizzazione è dove si blocca la maggior parte dei siti.
Fa parte di del manuale di QueryWin · Livello 1