Quando o CDN bloqueia crawlers de IA e o robots.txt não resolve
O navegador abre a página e o crawler de IA recebe 403: provavelmente o CDN está bloqueando o crawler antes do seu servidor. Veja como achar a borda e o ajuste certo.
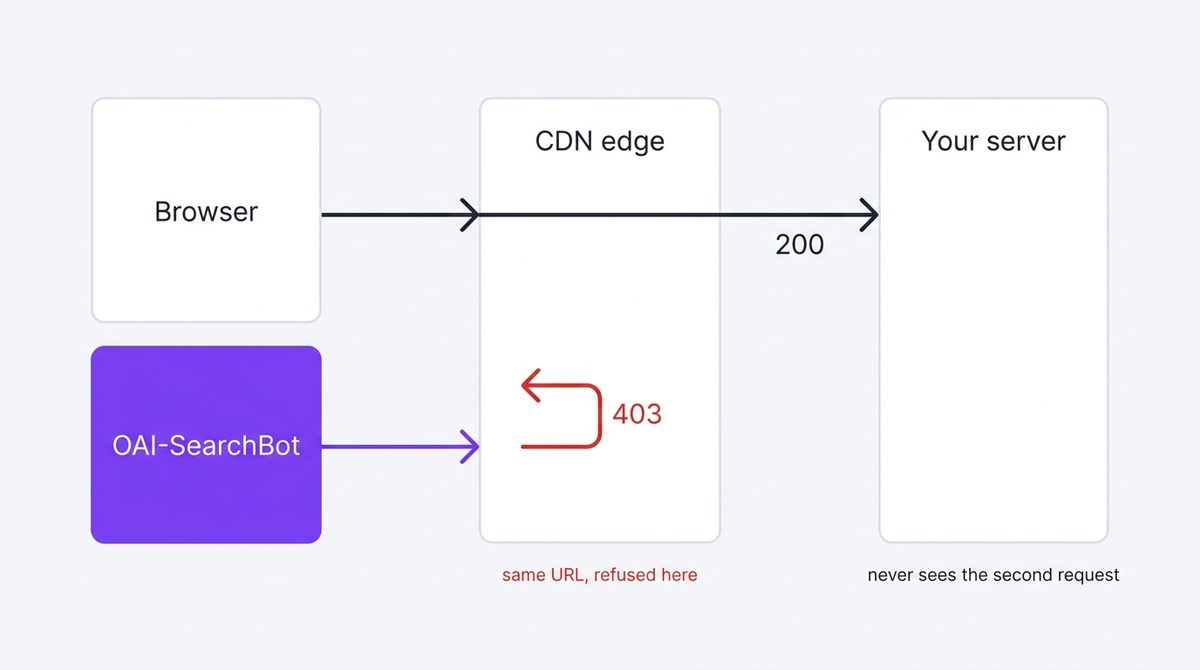
Se o navegador carrega a página mas um crawler de IA recebe 403, quase sempre o CDN está bloqueando o crawler de IA, e não há falha no seu servidor. A borda responde antes de o servidor ver a requisição, e um único cabeçalho identifica o fornecedor. Primeiro descubra a borda; depois vá aos controles de bots desse fornecedor. Editar seus próprios arquivos não remove um bloqueio aplicado pela hospedagem.
Leia isto primeiro
Este capítulo começa onde termina verificar se a IA consegue ler seu site. Se aquela checagem devolveu 200 para todos os crawlers, não há nada para corrigir aqui. Volte quando algo devolver 403 ou 503: esse é o sintoma que este capítulo diagnostica.
Por que o CDN bloqueia o que o seu robots.txt libera
O CDN responde antes de o servidor receber a requisição. Ele aplica as próprias regras de bots, publicadas pelo fornecedor e atualizadas no calendário dele, e não consulta o robots.txt para decidir. Por isso os dois podem se contradizer para sempre: seu arquivo diz para entrar, a borda diz não, e ambos funcionam como foram desenhados.
Ninguém pede sua permissão para mudar um padrão em seu nome. Verifique depois de cada mudança de plano.
Encontrar o CDN que bloqueia crawlers de IA com um comando
Você não precisa adivinhar. Os cabeçalhos de resposta dizem, porque cada borda grande assina a própria requisição. Um curl e uma comparação com a tabela resolvem.
curl -sI -A "Mozilla/5.0 (compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot)" \
https://example.com/ | grep -iE 'server|cf-ray|x-vercel|x-nf-request|x-served-by|x-amz-cf-id|x-cache'| Cabeçalho | Borda | Também aparece |
|---|---|---|
cf-ray | Cloudflare | server: cloudflare, cf-cache-status |
x-vercel-id | Vercel | server: Vercel, x-vercel-cache |
x-nf-request-id | Netlify | server: Netlify |
x-amz-cf-id | AWS CloudFront | x-cache |
x-served-by + x-cache | Fastly | um server próprio |
| nenhum | Sem CDN, ou um que se esconde | leia só server |
O que o teste em onze sites mostrou
Em 15 de agosto de 2026 enviei essa requisição exata, com o agente OAI-SearchBot, para onze sites conhecidos. Todos responderam 200. Nenhum site de marca grande recusou um crawler de busca com IA na borda naquele dia, o que vale saber antes de supor que o bloqueio é seu.
O resultado mais útil foi quem estava atrás da Cloudflare. shopify.com e webflow.com respondiam com cf-ray. Se você tem uma loja ou site em qualquer uma dessas plataformas, as regras que importam são as da Cloudflare, mesmo que você não administre essa conta.
Uma ressalva, a mesma de todas as checagens deste manual: as requisições saíam do meu endereço, não do endereço do crawler. Regras que filtram por faixa de IP continuam invisíveis neste teste.
Onde cada plataforma guarda os controles de crawlers de IA
Procure a função pelo nome, não pelo caminho do menu. Os fornecedores mudam menus o tempo todo, e um caminho velho manda você caçar algo que já foi renomeado.
| Plataforma | O que buscar | Padrão |
|---|---|---|
| Cloudflare | AI Crawl Control | Disponível em todos os planos |
| Vercel | Conjunto de regras para crawlers de IA | Inativo, aparece como Allow |
| Vercel | Regras gerenciadas de proteção de bots | Inativo, aparece como Off |
| Shopify | Modelo de tema robots.txt.liquid | Regras padrão da Shopify |
| Netlify / CloudFront | Regras de WAF ou firewall por agente | Sem regras específicas de IA |
A Vercel documenta os dois conjuntos como desligados até você ativá-los. Um site na Vercel que recusa crawlers de IA costuma estar sendo recusado em outro lugar. Fontes: Cloudflare, Vercel, Shopify.
Com duas bordas empilhadas, só a de fora responde
Muitos sites colocam uma plataforma na frente de outra; Cloudflare na frente da Vercel é a combinação comum. O serviço de fora responde, então os cabeçalhos que você vê e as regras que agem são dele. Os ajustes de bots da plataforma interna podem nunca ser consultados.
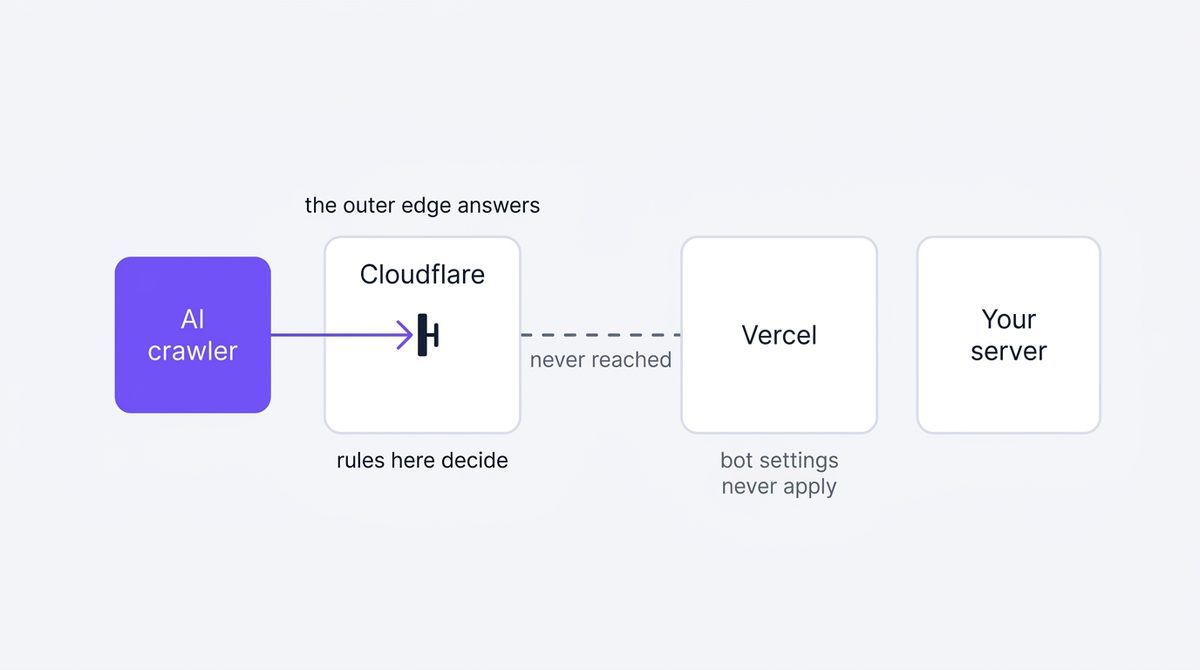
A Vercel diz na própria documentação: «Bot Protection doesn't work when a reverse proxy (e.g. Cloudflare, Azure, or other CDNs) is placed in front of your Vercel deployment.» Se os cabeçalhos mostram cf-ray, comece pela Cloudflare mesmo que você se considere um site Vercel.
Três jeitos de errar
Cada um custa uma tarde em um lugar onde a resposta não estava.
- Editar o robots.txt para corrigir um 403. Um 403 significa que a requisição foi recusada. O robots.txt é lido depois que a resposta chega, então não desfaz a recusa. Corrija a borda e depois use o robots.txt para declarar o que você quer.
- Testar no navegador e concluir que está tudo bem. As regras de bots dependem do agente, e o seu navegador é justamente o cliente que não vai reproduzir o problema. Teste de novo com o agente do crawler.
- Corrigir a plataforma interna enquanto a de fora recusa. Olhe os cabeçalhos antes de mudar um ajuste, ou você estará girando botões em um serviço que nunca viu a requisição.
Perguntas frequentes
Minha hospedagem diz que não bloqueia crawlers de IA. Por que recebo 403?
Regras de WAF gerenciadas, limites de taxa e páginas de desafio produzem recusas sem o rótulo de bloqueio de IA. Um 503 com página intermediária é um desafio, e crawlers não resolvem desafios: trate como bloqueio.
Dá para distinguir um bloqueio do CDN de um bloqueio do servidor?
Quase sempre. Uma recusa da borda chega rápido, traz cabeçalhos do CDN e nenhum da sua aplicação. Se a resposta tem os cabeçalhos do seu framework ou uma página que sua aplicação renderizou, a requisição chegou até você.
Por que o capítulo não dá passos com capturas do painel?
Porque publicaríamos caminhos de menu que não conseguimos reverificar a cada atualização dos fornecedores, e um caminho errado é pior do que nenhum. Nomes de funções mudam muito mais devagar que menus.
Próximo passo
Quando todos os crawlers recebem 200, o problema deixa de ser ser alcançado e passa a ser merecer o rastreamento. Isso quer dizer escolher as buscas que você está perto de ganhar; aí o manual sai do encanamento e entra no conteúdo.
Diagnosticar o bloqueio é a parte rápida. Fazer a mudança, publicar e empurrar a atualização para indexação é onde a maioria dos sites trava.
Faz parte do guia do QueryWin · Nível 1